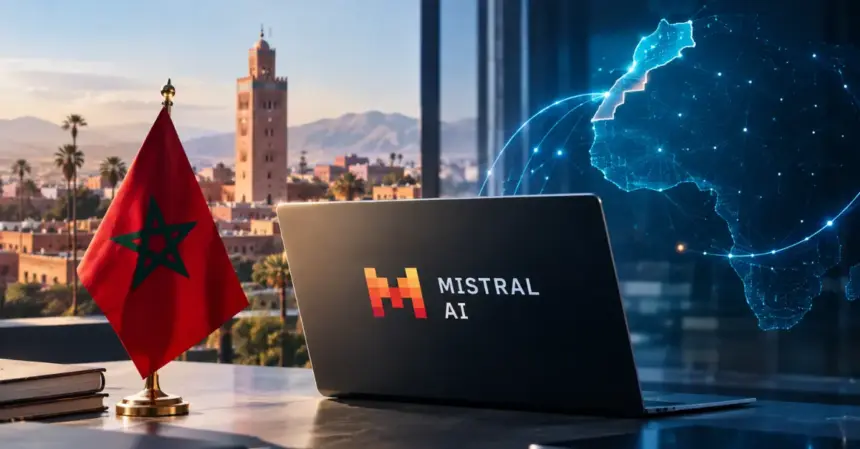
Le communiqué est sobre, mais le signal est net : Rabat veut que l’intelligence artificielle comprenne la langue que parlent ses citoyens. Je me suis penché sur ce que contient cette annonce, sur ce qu’elle ne dit pas encore et sur les raisons pour lesquelles elle dépasse le cadre technique.
Ce que le ministère a effectivement annoncé
Deux outils sont concernés. Le premier est un classificateur d’identification de la langue, capable de reconnaître et de distinguer plusieurs dialectes arabes, dont la darija marocaine. Le second est un modèle de reconnaissance automatique de la parole fondé sur la technologie Voxtral de Mistral AI. Il transcrit la parole en texte, y compris lorsque les locuteurs passent de l’arabe au français ou à l’anglais au fil d’une même conversation.
Selon le ministère, ces outils sont ou seront prochainement disponibles en open source. Les administrations, les startups, les chercheurs, les développeurs et les entreprises pourront s’en servir pour concevoir leurs propres applications. Le communiqué précise que d’autres modèles et d’autres cas d’usage sont en cours de développement dans le cadre de ce partenariat pluriannuel.
Cette annonce s’inscrit dans deux cadres officiels : la stratégie « Maroc Digital 2030 » et la feuille de route « AI Made in Morocco ». Toutes deux visent, selon les autorités, une intelligence artificielle « souveraine, responsable » et adaptée aux réalités linguistiques et culturelles du Royaume.
Les points clés
- Deux modèles : un identificateur de dialectes arabes (darija incluse) et un système de transcription vocale dérivé de Voxtral.
- Une transcription censée gérer l’alternance entre arabe, français et anglais.
- Une diffusion en open source, destinée aux administrations, aux entreprises, aux startups et à la recherche.
- Un partenariat pluriannuel avec Mistral AI, dont ces outils ne sont que la première étape.
Pourquoi la darija pose un problème particulier à l’IA
Pour un non-spécialiste, la difficulté peut sembler surprenante : l’arabe est l’une des langues les plus parlées au monde, et les systèmes d’IA le traitent déjà. Mais ils s’appuient surtout sur l’arabe standard moderne, celui des médias et des textes officiels. La darija est une autre réalité. C’est la langue du quotidien, de la rue, du foyer, des marchés, des réseaux sociaux et de plus en plus de la création audiovisuelle.
Elle a plusieurs particularités qui compliquent la tâche des machines. Elle s’écrit de manière peu standardisée, tantôt en caractères arabes, tantôt en caractères latins avec des chiffres pour certains sons. Elle emprunte abondamment au français, à l’espagnol et à l’amazighe. Et ses locuteurs changent de langue à l’intérieur d’une même phrase, un phénomène que les linguistes appellent alternance codique. Un système entraîné sur de l’arabe standard comprend mal ces échanges, et un système entraîné sur du français ne les comprend pas du tout.
Voilà pourquoi la mention de l’alternance entre arabe, français et anglais dans le communiqué me paraît importante. Elle indique que les concepteurs ont visé la parole telle qu’elle se pratique, et non une version idéalisée de la langue.
À quoi servent concrètement ces briques
Un classificateur de dialectes peut sembler anecdotique. C’est pourtant une brique d’infrastructure : avant de traiter un texte ou un enregistrement, il faut savoir de quelle variété de langue il relève. Cet outil sert à trier des corpus, à acheminer une requête vers le bon modèle ou à filtrer des données d’entraînement. Il est donc la condition de nombreux autres développements.
La transcription vocale a des applications plus visibles. Le ministère évoque l’amélioration de la qualité des services publics et de l’inclusion numérique. On peut imaginer des guichets vocaux dans les administrations, le sous-titrage automatique de contenus audiovisuels, la prise de notes dans des réunions ou l’accès aux services pour des personnes peu à l’aise avec l’écrit. Ce sont des hypothèses de ma part. Le ministère n’a pas, à ce stade, détaillé de déploiements précis ni de calendrier.
Un choix qui s’appuie sur une base existante
Il faut aussi comprendre ce que « développé avec Mistral » recouvre. Voxtral est une famille de modèles audio que Mistral AI a lancée en 2025 et rendue accessible sous licence ouverte. Selon l’analyse publiée par l’agence Ecofin, les nouveaux outils exploitent des modèles que la société avait déjà diffusés sous licences ouvertes, et la documentation distingue le modèle Voxtral d’origine de l’adaptation à la darija réalisée pour Rabat.
Ce n’est pas un reproche. Adapter un modèle généraliste à une langue ou à un dialecte est la voie la plus économique et la plus réaliste pour un pays qui ne dispose pas des moyens de calcul des grands groupes américains ou chinois. Mais le terme « souverain » doit être manié avec précision. Ici, la souveraineté tient moins à la maîtrise de bout en bout de la technologie qu’à la maîtrise des données linguistiques, des usages et, à terme, des applications qui en découleront.
La nuance entre « open source » et « open weight » mérite aussi d’être rappelée. Mistral se décrit lui-même comme un concepteur de modèles à poids ouverts : les paramètres sont publiés et réutilisables, mais les données d’entraînement ne le sont pas toujours. Selon les termes exacts de la licence, la liberté de réutilisation, de modification et de commercialisation pourra varier. C’est un point que les développeurs marocains examineront de près.
Les enjeux économiques et stratégiques
Sur le plan économique, l’ouverture des modèles abaisse la barrière d’entrée pour l’écosystème local. Une jeune pousse de Casablanca ou de Rabat peut bâtir un service de transcription ou un assistant vocal sans repartir de zéro. Les chercheurs des universités marocaines disposent, eux, d’une base de travail commune pour mesurer, comparer et améliorer. Si la dynamique prend, elle peut stimuler un secteur où le Maroc cherche à se positionner, entre services numériques, externalisation et production de contenus.
Sur le plan stratégique, l’enjeu est la dépendance. Les grandes plateformes américaines traitent déjà la darija, mais de façon inégale et selon des priorités commerciales qui ne sont pas celles des administrations marocaines. Disposer d’outils ouverts permet d’héberger les traitements sur des serveurs nationaux, ce qui répond à des préoccupations de confidentialité des données publiques.
Sur le plan géopolitique, l’annonce s’inscrit dans le rapprochement entre Paris et Rabat observé ces dernières années. Pour la France, associer un fleuron de l’IA à un pays du Sud, dans une langue que n’accompagnent pas les géants américains, relève d’une logique d’influence : exporter un modèle de coopération fondé sur l’ouverture plutôt que sur la dépendance. Pour le Maroc, diversifier ses partenaires technologiques est une constante de sa diplomatie économique.
Les réserves et les questions ouvertes
Plusieurs points demeurent sans réponse, et je préfère les formuler plutôt que les contourner.
D’abord, la qualité. Aucun indicateur de performance n’a été communiqué, ni taux d’erreur sur la transcription, ni comparaison avec les solutions existantes. Tant que des évaluations indépendantes n’auront pas été publiées, il est prématuré de juger de la fiabilité des modèles, notamment face à la diversité des accents régionaux.
Ensuite, les données. On ignore comment les corpus d’entraînement ont été constitués, par qui, avec quelles garanties de consentement et de protection de la vie privée. Les enregistrements vocaux sont des données sensibles, et la question mérite d’être posée à mesure que ces outils seront utilisés dans les services publics.
Enfin, l’appropriation. Un modèle ouvert ne produit de valeur que si des équipes compétentes s’en emparent. Cela suppose des moyens de calcul, des talents et des cas d’usage financés. Le communiqué évoque la montée en compétence de l’écosystème national, mais l’essentiel reste à construire.
Il existe aussi un point de vue plus critique. Certains observateurs jugent que ces annonces valorisent davantage l’image des institutions que les usages réels, et qu’une feuille de route ne vaut que par ses déploiements. À l’inverse, ses défenseurs soulignent que l’ouverture des outils permet précisément à chacun de vérifier la promesse.
Une première étape à juger sur la durée
Je retiens de cette annonce un pari raisonnable, bien cadré et encore modeste. Ces deux outils ne font pas du Maroc une puissance de l’IA. Ils posent en revanche une base technique sur une langue longtemps négligée par les systèmes numériques. Reste à savoir si cette base sera adoptée, évaluée et enrichie, ou si elle restera un communiqué de plus. La réponse viendra des premiers produits qui l’utiliseront, et de la transparence avec laquelle leurs résultats seront publiés.
FAQ
Qu’est-ce que Voxtral ?
Voxtral est une famille de modèles de traitement de la parole développée par Mistral AI, société française d’intelligence artificielle. Dans cette annonce, elle sert de base à un modèle de transcription adapté à la darija.
Les outils sont-ils gratuits et accessibles à tous ?
Le ministère indique qu’ils sont, ou seront prochainement, diffusés en open source à l’intention des administrations, des entreprises, des startups, des chercheurs et des développeurs. Les conditions précises dépendront de la licence retenue, qu’il faudra consulter à la publication.
Ces modèles comprennent-ils les mélanges de langues ?
Selon le communiqué, le modèle de reconnaissance vocale transcrit la parole même lorsqu’elle alterne entre arabe, français et anglais. Aucun chiffre de performance n’a toutefois été rendu public.
Pourquoi la darija pose-t-elle problème aux IA actuelles ?
Elle est peu standardisée à l’écrit, riche en emprunts et souvent mêlée à d’autres langues. Les systèmes entraînés surtout sur l’arabe standard ou sur des langues européennes la traitent donc mal.