Le modèle s’appelle SpikingBrain. Il existe bel et bien, il est documenté dans un rapport technique public, et ses résultats méritent l’attention. Mais entre ce que disent les chercheurs et ce que répète la viralité, l’écart est considérable. J’ai voulu séparer l’un de l’autre.
Ce que dit réellement l’étude
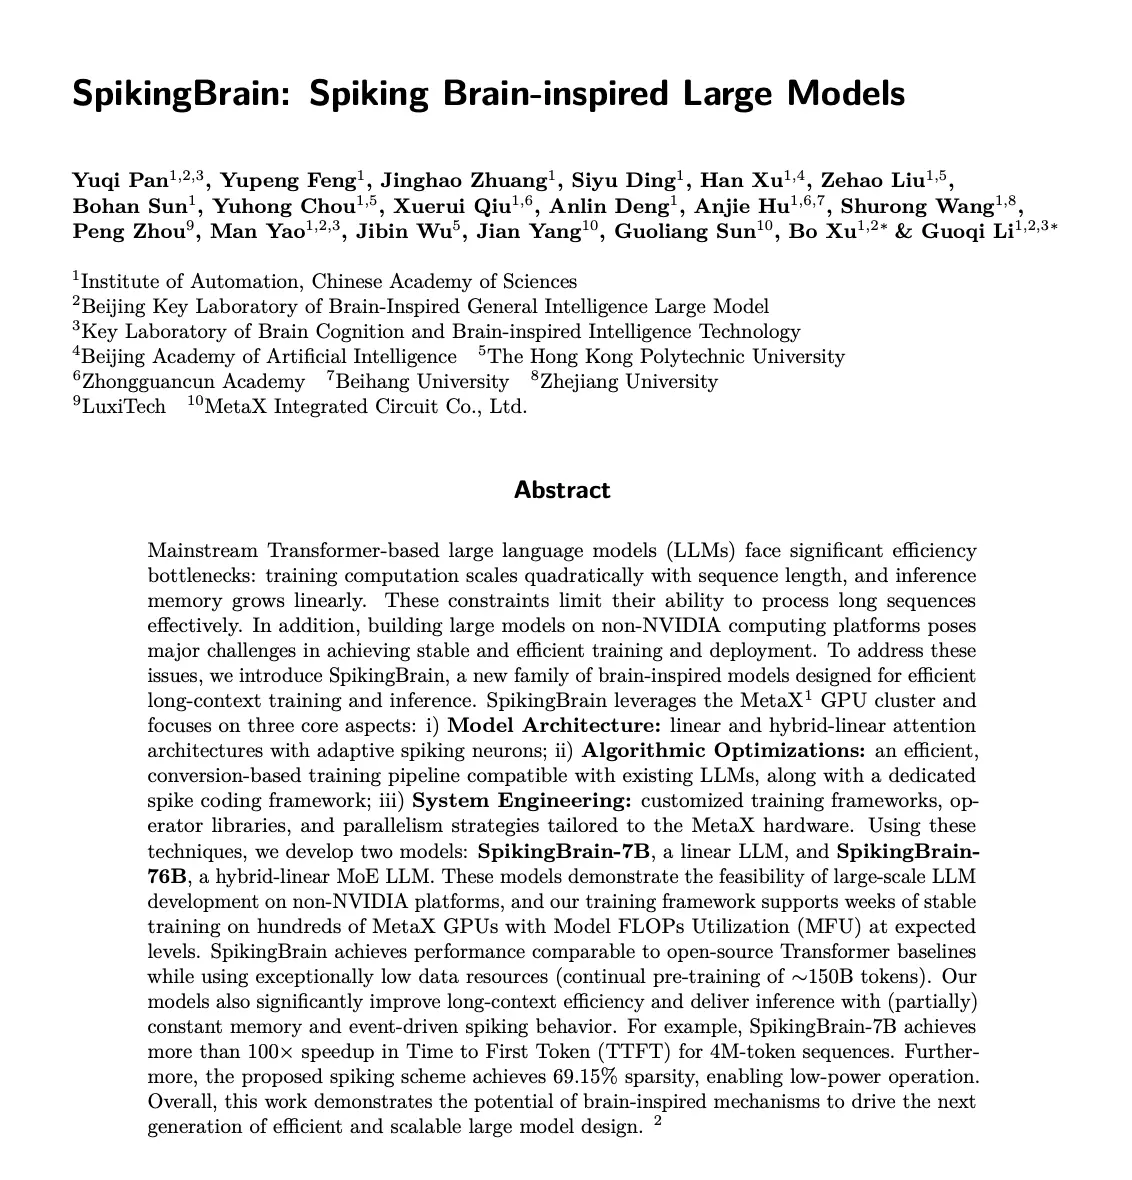
SpikingBrain est une famille de modèles de langage développée par l’Institut d’automatisation de l’Académie chinoise des sciences, à Pékin. Plusieurs établissements sont associés au projet, dont l’entreprise de semi-conducteurs MetaX, la société LuxiTech, l’Université polytechnique de Hong Kong et l’Académie d’intelligence artificielle de Pékin. Parmi les signataires figurent Bo Xu et Guoqi Li, ce dernier étant présenté comme le chercheur à l’origine de l’approche.
La famille comprend deux modèles. SpikingBrain-7B, d’abord, est un modèle dit « linéaire » de 7 milliards de paramètres. SpikingBrain-76B, ensuite, est un modèle hybride à « mélange d’experts », dans lequel seule une partie des paramètres, de l’ordre de 12 milliards d’après la désignation du modèle, est sollicitée pour chaque mot traité.
Les auteurs avancent trois résultats principaux. Le premier est une accélération de plus de cent fois du délai avant le premier jeton (TTFT) pour des séquences de 4 millions de jetons, mesurée sur le modèle de 7 milliards de paramètres. Le deuxième est une performance jugée comparable à celle de modèles Transformer open source de référence, avec seulement 150 milliards de jetons de pré-entraînement continu. Le troisième est une activation parcimonieuse : 69,15 % des opérations de type « impulsion » restent silencieuses.
Ces chiffres sont ceux des chercheurs eux-mêmes. À ma connaissance, aucune reproduction indépendante de grande ampleur n’a été publiée à ce stade, point qu’il conviendra de réexaminer.
Pourquoi les Transformers butent sur les longs contextes
Pour mesurer l’enjeu, il faut revenir au fonctionnement des modèles dominants, de l’architecture Transformer. Son mécanisme central, l’attention, compare chaque mot d’un texte à tous les autres. Le coût de calcul croît donc de manière quadratique avec la longueur de la séquence : doubler le texte revient à quadrupler l’effort. À l’inférence, la mémoire nécessaire pour conserver le contexte grandit de son côté linéairement avec le nombre de jetons.
C’est le goulot d’étranglement des « longs contextes », qu’il s’agisse d’analyser un dossier juridique entier, une base de code ou des heures de transcription. Les rapporteurs du projet le rappellent en ouverture : ces contraintes limitent la capacité des modèles à traiter efficacement de très longues séquences.
SpikingBrain s’attaque à ce point précis. Les architectures dites linéaires remplacent l’attention classique par un mécanisme dont le coût croît proportionnellement à la longueur du texte, et non plus au carré. Le modèle de 7 milliards de paramètres conserve en outre une empreinte mémoire constante, quelle que soit la longueur de l’entrée. Le modèle de 76 milliards la conserve en partie seulement, grâce à son architecture hybride.
Des neurones à impulsions, comment ça marche
La seconde idée, celle qui a donné son nom au projet, vient des neurosciences. Dans un réseau de neurones artificiels classique, chaque neurone calcule en permanence une valeur continue. Dans un cerveau biologique, un neurone reste silencieux tant qu’un seuil n’est pas franchi, puis émet une brève impulsion, un « spike ». L’information tient alors dans le moment et la fréquence de ces impulsions, plus que dans une valeur chiffrée.
SpikingBrain emprunte ce principe avec des neurones dits « à émission adaptative », dont le seuil d’activation s’ajuste. Concrètement, une grande partie des calculs n’a pas lieu quand le signal est nul. D’où cette parcimonie de 69,15 % : près de sept opérations sur dix sont évitées. Le slogan selon lequel la machine « ne pense que lorsqu’elle en a besoin » est une image séduisante, mais elle reste une image. Le modèle ne décide pas de réfléchir : certains de ses neurones artificiels restent simplement à zéro.
Autre point souvent passé sous silence, les chercheurs n’ont pas construit leurs modèles à partir de rien. Ils décrivent un pipeline d’entraînement par conversion, compatible avec des modèles existants. Les 150 milliards de jetons mentionnés correspondent à une phase de pré-entraînement continu. Les schémas du rapport rappellent que la phase initiale de pré-entraînement portait sur plus de 10 000 milliards de jetons. Parler d’un modèle entraîné avec « une fraction des données » est donc exact pour cette étape, mais cela ne signifie pas qu’on peut désormais fabriquer un modèle de ce niveau avec 2 % des ressources.
Les chiffres à lire avec précaution
Voici les chiffres clés, avec leur périmètre exact :
- Accélération supérieure à 100× du TTFT, pour des séquences de 4 millions de jetons, avec le modèle de 7 milliards de paramètres, face à des références Transformer.
- 69,15 % de parcimonie dans le schéma d’impulsions proposé.
- Environ 150 milliards de jetons de pré-entraînement continu, pour des performances jugées comparables à celles de références open source.
- Un entraînement stable pendant plusieurs semaines sur des centaines de puces MetaX C550.
- Une version compressée de 1 milliard de paramètres, déployée sur processeurs mobiles, qui affiche selon les auteurs un gain d’environ 15 fois sur des séquences de 256 000 jetons.
Reste le chiffre qui a fait le tour du web, celui des 97 % d’énergie économisée. Il n’apparaît pas dans le résumé du rapport, qui parle seulement d’un fonctionnement « à faible consommation » rendu possible par la parcimonie. D’après mes lectures, il relève d’une estimation théorique portant sur les opérations élémentaires, et non d’une mesure de consommation électrique d’un système en conditions réelles. La distinction est essentielle. Les processeurs graphiques actuels sont conçus pour des calculs denses. Ils tirent mal parti d’une activité éparse, de sorte que les économies théoriques ne se traduisent pas mécaniquement en économies sur la facture d’électricité. Les gains complets supposent, à terme, des puces neuromorphiques ou des circuits pensés pour un fonctionnement événementiel.
De même, l’accélération de 100× ne dit pas que SpikingBrain est cent fois plus rapide que les modèles actuels dans l’usage courant. Elle décrit un cas extrême, celui d’une très longue entrée où l’attention quadratique est précisément à son pire. Sur des textes courts, l’écart se réduit nettement, et les modèles de pointe ont par ailleurs multiplié les optimisations pour contenir ce coût.
Un enjeu géopolitique autant que technique
Au-delà de l’architecture, une partie de l’intérêt du projet tient au matériel. Les auteurs mettent en avant le fait que l’entraînement et le déploiement ont eu lieu sur une grappe de puces MetaX, un fabricant chinois, plutôt que sur des composants Nvidia. Ils y voient la preuve qu’on peut développer de grands modèles sur une plateforme non Nvidia, avec un entraînement stable sur plusieurs semaines.
Dans le contexte des restrictions américaines à l’exportation de semi-conducteurs avancés vers la Chine, le message est lisible. Il s’agit de montrer qu’un écosystème national, du logiciel jusqu’aux puces, peut fonctionner. Guoqi Li présente d’ailleurs le projet comme une voie nouvelle, optimisée pour les plateformes chinoises.
Il faut pourtant éviter de parler de contournement « complet » de la dépendance occidentale. Entraîner un modèle de 7 ou de 76 milliards de paramètres est loin des échelles atteintes par les laboratoires américains les plus avancés. Surtout, la question industrielle demeure : produire ces puces en volume, à performance et à coût compétitifs, reste un défi distinct de la démonstration scientifique.
Les réserves que l’on peut formuler
Plusieurs questions restent ouvertes, et je les formule en mon nom, faute de réaction indépendante documentée à ce stade.
La première concerne la qualité. Des performances « comparables » à celles de références open source ne veulent pas dire équivalentes aux meilleurs modèles du moment. Elles ne disent rien non plus de la robustesse du modèle sur des tâches de raisonnement complexe ou sur des contextes réellement multi-millions de jetons.
La deuxième touche à la comparaison elle-même. Un gain de 100× dépend du modèle de référence choisi, de son implémentation et du matériel utilisé. Seule une évaluation menée par des tiers, sur des bases communes, permettra de le consolider. Le code du modèle de 7 milliards de paramètres a été rendu public, ce qui rend cette vérification possible.
La troisième est celle du matériel. Si l’avantage énergétique se confirme sur des circuits adaptés, il faudra encore que ces circuits existent à l’échelle industrielle. Pour l’instant, l’IA événementielle tourne sur du matériel qui n’a pas été pensé pour elle.
À l’inverse, les sceptiques auraient tort de balayer le sujet. L’idée de réduire la dépendance au calcul dense, d’alléger le coût des longs contextes et de rendre l’IA exécutable sur des appareils modestes répond à un besoin réel, à l’heure où la consommation électrique des centres de données devient un sujet politique.
Et maintenant
Je retiens de SpikingBrain moins une rupture qu’un signal. Une équipe de recherche a montré qu’il était possible de convertir des modèles existants vers une architecture plus économe, de l’entraîner de façon stable sur du matériel non Nvidia et d’obtenir des gains très marqués sur une catégorie précise de tâches. C’est suffisant pour justifier l’attention, pas pour parler de « cerveau humain » ni de révolution acquise.
La suite se jouera sur trois terrains : les évaluations indépendantes, l’arrivée éventuelle de matériel adapté aux réseaux à impulsions et la capacité à passer à des modèles de plus grande taille. La nature a peut-être résolu le problème de l’efficacité il y a des millions d’années, mais l’ingénierie, elle, n’a pas fini de rattraper son retard.
FAQ
SpikingBrain fonctionne-t-il vraiment comme un cerveau humain ?
Non. Il s’inspire de certains principes biologiques, comme l’activation par seuil et par impulsions, mais reste un modèle de langage mathématique qui tourne sur des puces conventionnelles.
L’accélération de 100× vaut-elle pour tous les usages ?
Non. Elle concerne le délai avant le premier jeton, pour une entrée de 4 millions de jetons, avec le modèle de 7 milliards de paramètres. Sur des textes courts, l’écart est bien moindre.
SpikingBrain se passe-t-il de Nvidia ?
Il a été entraîné et testé sur des puces MetaX, un fabricant chinois. Cela démontre la faisabilité technique, mais pas qu’une production à grande échelle soit déjà possible sans composants occidentaux.
Peut-on vérifier ces résultats ?
En partie. Le rapport technique est public et le code du modèle de 7 milliards de paramètres est disponible, ce qui permet à des équipes indépendantes de tester les résultats annoncés.