اسم هذا النموذج SpikingBrain. وهو موجود فعلاً، وموثّق في تقرير تقني منشور للعموم، ونتائجه جديرة بالاهتمام. لكن الفجوة كبيرة بين ما يقوله الباحثون وما تردّده موجة الانتشار الواسع. وقد أردت أن أفصل بين الأمرين.
ما الذي تقوله الدراسة فعلاً؟
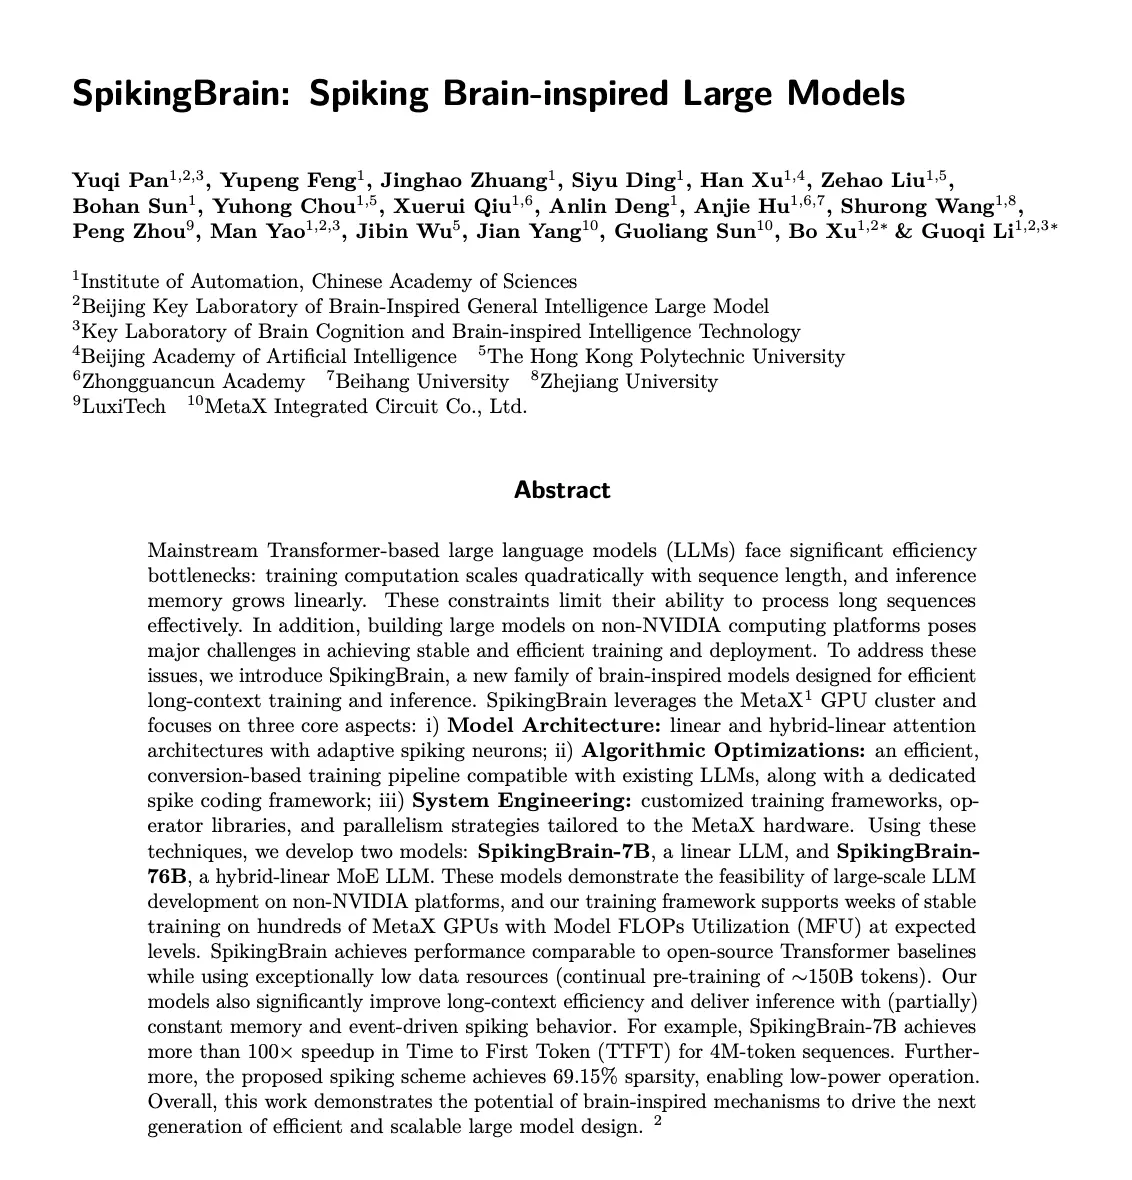
SpikingBrain عائلة من النماذج اللغوية طوّرها معهد الأتمتة التابع للأكاديمية الصينية للعلوم في بكين. ويشارك في المشروع عدة جهات، من بينها شركة أشباه الموصلات MetaX، وشركة LuxiTech، وجامعة هونغ كونغ للفنون التطبيقية (البوليتكنيك)، وأكاديمية بكين للذكاء الاصطناعي. ومن بين الموقّعين على التقرير Bo Xu وGuoqi Li، ويُقدَّم الأخير بوصفه الباحث الذي يقف وراء هذا النهج.
تضم العائلة نموذجين. الأول SpikingBrain-7B، وهو نموذج «خطّي» يضم 7 مليارات معامل. والثاني SpikingBrain-76B، وهو نموذج هجين من نوع «مزيج الخبراء»، لا يُستدعى فيه لمعالجة كل كلمة سوى جزء من المعاملات، يبلغ نحو 12 مليار معامل بحسب تسمية النموذج.
يعرض المؤلفون ثلاث نتائج رئيسية. الأولى تسريع يفوق 100 مرة في زمن ظهور الرمز الأول (TTFT) لتسلسلات من 4 ملايين رمز، وقد قيس على النموذج ذي 7 مليارات معامل. والثانية أداء يُوصف بأنه مماثل لأداء نماذج Transformer مفتوحة المصدر مرجعية، مع 150 مليار رمز فقط من التدريب المسبق المتواصل. والثالثة تنشيط متناثر: 69,15% من العمليات من نوع «النبضات» تظل صامتة.
هذه الأرقام صادرة عن الباحثين أنفسهم. وعلى حدّ علمي، لم تُنشر حتى الآن أي عملية إعادة إنتاج مستقلة واسعة النطاق، وهي نقطة ينبغي العودة إليها لاحقاً.
لماذا تتعثر نماذج Transformer مع السياقات الطويلة؟
لتقدير حجم الرهان، لا بد من العودة إلى طريقة عمل النماذج السائدة، أي بنية Transformer. آليتها المركزية، وهي «الانتباه»، تقارن كل كلمة في النص بجميع الكلمات الأخرى. لذلك تنمو كلفة الحساب نمواً تربيعياً مع طول التسلسل، فمضاعفة النص تعني مضاعفة الجهد أربع مرات. أما في مرحلة الاستدلال، فتنمو الذاكرة اللازمة للاحتفاظ بالسياق خطياً مع عدد الرموز.
وهذا هو عنق الزجاجة في «السياقات الطويلة»، سواء تعلق الأمر بتحليل ملف قانوني كامل، أو قاعدة شيفرة برمجية، أو ساعات من التفريغ النصي. ويذكّر معدّو التقرير بذلك في مستهل عملهم: فهذه القيود تحدّ من قدرة النماذج على معالجة التسلسلات الطويلة جداً بكفاءة.
يستهدف SpikingBrain هذه النقطة تحديداً. فالبنى المسماة «خطّية» تستبدل بالانتباه الكلاسيكي آلية تنمو كلفتها طردياً مع طول النص، لا بالتربيع. كما يحافظ النموذج ذو 7 مليارات معامل على بصمة ذاكرة ثابتة مهما كان طول المدخل. أما النموذج ذو 76 مليار معامل فيحافظ عليها جزئياً فقط، بفضل بنيته الهجينة.
الخلايا العصبية النبضية: كيف تعمل؟
الفكرة الثانية، وهي التي أعطت المشروع اسمه، مصدرها علم الأعصاب. ففي الشبكة العصبية الاصطناعية الكلاسيكية، يحسب كل عصبون باستمرار قيمة متصلة. أما في الدماغ البيولوجي، فيظل العصبون صامتاً ما لم يُتجاوز عتبة معينة، ثم يطلق نبضة وجيزة تسمى «spike». وعندئذ تكمن المعلومة في توقيت هذه النبضات وتواترها أكثر مما تكمن في قيمة رقمية.
يستعير SpikingBrain هذا المبدأ عبر عصبونات تسمى «ذات الإطلاق التكيفي»، تتعدّل عتبة تنشيطها. وعملياً، لا يجري جزء كبير من الحسابات حين تكون الإشارة معدومة. ومن هنا جاء التناثر البالغ 69,15%: أي أن نحو سبع عمليات من كل عشر تُتجنَّب. أما الشعار القائل إن الآلة «لا تفكّر إلا عند الحاجة» فهو صورة جذابة، لكنها تبقى مجرد صورة. فالنموذج لا يقرر أن يفكّر، بل إن بعض عصبوناته الاصطناعية تبقى ببساطة عند الصفر.
وثمة نقطة أخرى كثيراً ما يُسكت عنها: لم يبنِ الباحثون نماذجهم من الصفر. فهم يصفون مسار تدريب بالتحويل، متوافقاً مع النماذج الموجودة. أما الـ150 مليار رمز المذكورة فتقابل مرحلة تدريب مسبق متواصل. وتذكّر مخططات التقرير بأن مرحلة التدريب المسبق الأولى شملت أكثر من 10 آلاف مليار رمز. وبالتالي فإن القول بنموذج دُرّب على «جزء من البيانات» صحيح بالنسبة لهذه المرحلة، لكنه لا يعني أنه صار بالإمكان تصنيع نموذج بهذا المستوى بـ2% من الموارد.
أرقام تُقرأ بحذر
فيما يلي الأرقام الرئيسية مع نطاقها الدقيق:
- تسريع يزيد على 100 مرة في زمن ظهور الرمز الأول (TTFT)، لتسلسلات من 4 ملايين رمز، مع النموذج ذي 7 مليارات معامل، مقارنةً بمراجع من نوع Transformer.
- تناثر بنسبة 69,15% في مخطط النبضات المقترح.
- نحو 150 مليار رمز من التدريب المسبق المتواصل، للوصول إلى أداء يُوصف بأنه مماثل لمراجع مفتوحة المصدر.
- تدريب مستقر لعدة أسابيع على مئات من شرائح MetaX C550.
- نسخة مضغوطة بمليار معامل، نُشرت على معالجات الهواتف المحمولة، وتحقق بحسب المؤلفين تسريعاً يقارب 15 مرة على تسلسلات من 256 ألف رمز.
يبقى الرقم الذي جاب الشبكة، أي 97% من الطاقة المدّخرة. هذا الرقم لا يرد في ملخص التقرير، الذي يتحدث فقط عن تشغيل «منخفض الاستهلاك» تتيحه خاصية التناثر. ووفقاً لما اطلعت عليه، فهو تقدير نظري يخص العمليات الأولية، وليس قياساً للاستهلاك الكهربائي لنظام يعمل في ظروف حقيقية. والتمييز هنا جوهري. فمعالجات الرسوميات الحالية مصمَّمة للحسابات الكثيفة، ولا تستفيد جيداً من النشاط المتناثر، ولذلك لا تتحول الوفورات النظرية آلياً إلى وفورات في فاتورة الكهرباء. وتحقيق المكاسب الكاملة يفترض، في المستقبل، شرائح عصبية الشكل (neuromorphic) أو دوائر مصممة للعمل القائم على الأحداث.
وبالمثل، فإن التسريع بمقدار 100 مرة لا يعني أن SpikingBrain أسرع بمئة مرة من النماذج الحالية في الاستخدام اليومي. إنه يصف حالة قصوى، هي مدخل طويل جداً يكون فيه الانتباه التربيعي في أسوأ حالاته. أما على النصوص القصيرة فيتقلص الفارق بوضوح، كما أن النماذج المتقدمة راكمت تحسينات كثيرة لاحتواء هذه الكلفة.
رهان جيوسياسي بقدر ما هو تقني
إلى جانب البنية المعمارية، يكمن جزء من أهمية المشروع في العتاد. فالمؤلفون يبرزون أن التدريب والنشر جرى على عنقود من شرائح MetaX، وهي شركة تصنيع صينية، بدلاً من مكوّنات Nvidia. ويرون في ذلك دليلاً على إمكانية تطوير نماذج كبيرة على منصة غير تابعة لـNvidia، مع تدريب مستقر على مدى أسابيع.
وفي سياق القيود الأمريكية على تصدير أشباه الموصلات المتقدمة إلى الصين، فإن الرسالة واضحة. المقصود إثبات أن منظومة وطنية، من البرمجيات إلى الشرائح، قادرة على العمل. ويقدّم Guoqi Li المشروع، بالمناسبة، بوصفه مساراً جديداً مُحسَّناً للمنصات الصينية.
ومع ذلك، ينبغي تجنّب الحديث عن تجاوز «كامل» للاعتماد على الغرب. فتدريب نموذج بـ7 أو 76 مليار معامل بعيد عن المقاييس التي بلغتها أكثر المختبرات الأمريكية تقدماً. والأهم أن المسألة الصناعية تظل قائمة: فإنتاج هذه الشرائح بكميات كبيرة وبأداء وكلفة تنافسيين تحدٍّ مستقل عن الإثبات العلمي.
التحفظات الممكنة
تبقى عدة أسئلة مفتوحة، وأصوغها باسمي، لغياب ردود فعل مستقلة موثّقة حتى الآن.
الأول يتعلق بالجودة. فأداء «مماثل» لمراجع مفتوحة المصدر لا يعني أداءً مكافئاً لأفضل النماذج الحالية. كما أنه لا يقول شيئاً عن متانة النموذج في مهام الاستدلال المعقدة أو في سياقات تبلغ فعلاً عدة ملايين من الرموز.
الثاني يمسّ المقارنة ذاتها. فمكسب 100 مرة يتوقف على النموذج المرجعي المختار، وعلى طريقة تنفيذه، وعلى العتاد المستخدم. ولن يتمكن من ترسيخه إلا تقييم يجريه أطراف ثالثة على أسس مشتركة. وقد نُشرت شيفرة النموذج ذي 7 مليارات معامل، وهو ما يجعل هذا التحقق ممكناً.
الثالث يخص العتاد. فإن تأكدت الميزة الطاقية على دوائر ملائمة، فسيلزم أيضاً أن توجد هذه الدوائر على نطاق صناعي. وفي الوقت الراهن، يعمل الذكاء الاصطناعي القائم على الأحداث على عتاد لم يُصمَّم له.
وبالمقابل، سيكون المشككون مخطئين إن نبذوا الموضوع جملةً. فالفكرة القائلة بتقليص الاعتماد على الحساب الكثيف، وتخفيف كلفة السياقات الطويلة، وجعل الذكاء الاصطناعي قابلاً للتشغيل على أجهزة متواضعة، تستجيب لحاجة حقيقية، في وقت يتحول فيه استهلاك مراكز البيانات للكهرباء إلى قضية سياسية.
وماذا بعد؟
ما أخرج به من SpikingBrain هو إشارة أكثر منه قطيعة. فقد أثبت فريق بحثي أنه من الممكن تحويل نماذج موجودة إلى بنية أكثر اقتصاداً، وتدريبها بشكل مستقر على عتاد غير تابع لـNvidia، وتحقيق مكاسب بارزة جداً في فئة محددة من المهام. وهذا يكفي لتبرير الاهتمام، لكنه لا يكفي للحديث عن «دماغ بشري» ولا عن ثورة مكتملة.
وستُحسم الخطوة التالية على ثلاثة مسارات: التقييمات المستقلة، والظهور المحتمل لعتاد ملائم للشبكات النبضية، والقدرة على الانتقال إلى نماذج أكبر حجماً. فربما حلّت الطبيعة مشكلة الكفاءة قبل ملايين السنين، لكن الهندسة لم تنتهِ بعد من تعويض تأخرها.
الأسئلة الشائعة
هل يعمل SpikingBrain فعلاً مثل الدماغ البشري؟
لا. هو يستلهم بعض المبادئ البيولوجية، مثل التنشيط بالعتبة والنبضات، لكنه يظل نموذجاً لغوياً رياضياً يعمل على شرائح تقليدية.
هل التسريع بمقدار 100 مرة صالح لجميع الاستخدامات؟
لا. فهو يخص زمن ظهور الرمز الأول، لمدخل من 4 ملايين رمز، مع النموذج ذي 7 مليارات معامل. أما على النصوص القصيرة فالفارق أقل بكثير.
هل يستغني SpikingBrain عن Nvidia؟
لقد دُرّب واختُبر على شرائح MetaX، وهي شركة تصنيع صينية. وهذا يثبت الجدوى التقنية، لكنه لا يثبت أن الإنتاج على نطاق واسع بات ممكناً دون مكوّنات غربية.
هل يمكن التحقق من هذه النتائج؟
جزئياً. فالتقرير التقني متاح للعموم، وشيفرة النموذج ذي 7 مليارات معامل متوفرة، مما يتيح لفرق مستقلة اختبار النتائج المعلنة.