El modelo se llama SpikingBrain. Existe de verdad, está documentado en un informe técnico público y sus resultados merecen atención. Pero entre lo que dicen los investigadores y lo que se ha vuelto viral hay una distancia considerable. He querido separar lo uno de lo otro.
Lo que dice realmente el estudio
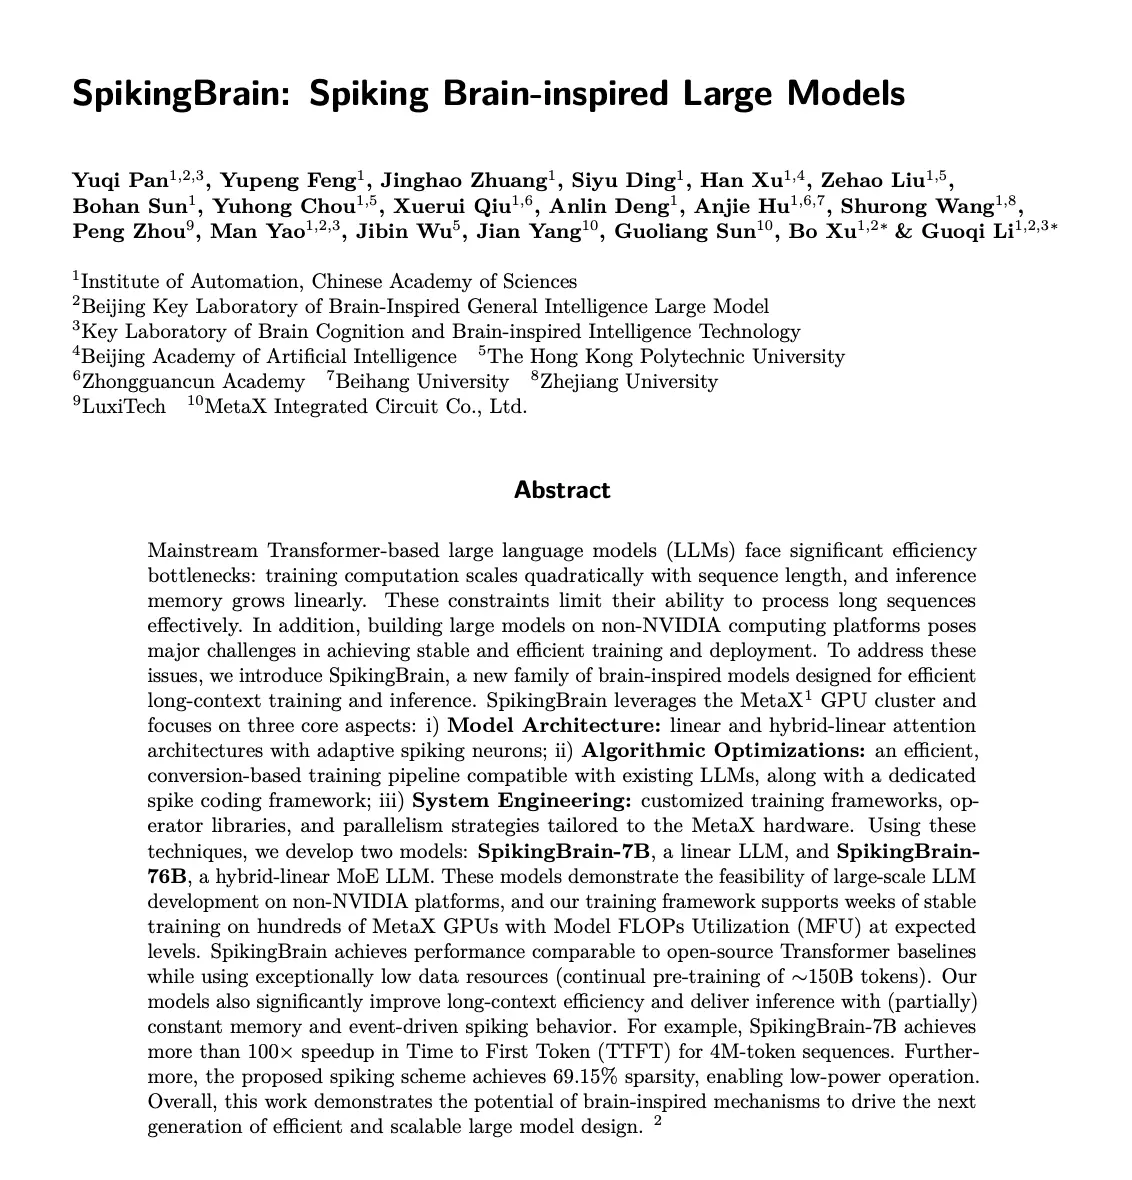
SpikingBrain es una familia de modelos de lenguaje desarrollada por el Instituto de Automatización de la Academia China de Ciencias, en Pekín. En el proyecto participan varias instituciones, entre ellas la empresa de semiconductores MetaX, la firma LuxiTech, la Universidad Politécnica de Hong Kong y la Academia de Inteligencia Artificial de Pekín. Entre los autores figuran Bo Xu y Guoqi Li, este último presentado como el investigador detrás del enfoque.
La familia incluye dos modelos. SpikingBrain-7B es un modelo «lineal» de 7.000 millones de parámetros. SpikingBrain-76B es un modelo híbrido de «mezcla de expertos», en el que solo una parte de los parámetros, unos 12.000 millones a juzgar por la designación del modelo, se utiliza para cada palabra procesada.
Los autores presentan tres resultados principales. El primero es una aceleración de más de cien veces en el tiempo hasta el primer token (TTFT) para secuencias de 4 millones de tokens, medida con el modelo de 7.000 millones de parámetros. El segundo es un rendimiento calificado de comparable al de los principales modelos Transformer de código abierto, con solo 150.000 millones de tokens de preentrenamiento continuo. El tercero es la activación dispersa: el 69,15 % de las operaciones basadas en impulsos permanece en silencio.
Estas cifras proceden de los propios investigadores. Hasta donde sé, no se ha publicado todavía ninguna réplica independiente a gran escala, un punto que habrá que revisar.
Por qué los Transformers se atascan con los contextos largos
Para medir lo que está en juego, conviene recordar cómo funcionan los modelos dominantes, los basados en la arquitectura Transformer. Su mecanismo central, la atención, compara cada palabra de un texto con todas las demás. El coste de cálculo crece, por tanto, de forma cuadrática con la longitud de la secuencia: duplicar el texto equivale a multiplicar por cuatro el esfuerzo. En la inferencia, la memoria necesaria para conservar el contexto crece a su vez de forma lineal con el número de tokens.
Ese es el cuello de botella de los «contextos largos», ya se trate de analizar un expediente jurídico completo, una base de código o horas de transcripciones. Los autores lo recuerdan al abrir su informe: estas limitaciones reducen la capacidad de los modelos para procesar secuencias largas con eficacia.
SpikingBrain ataca precisamente ese punto. Las arquitecturas llamadas lineales sustituyen la atención clásica por un mecanismo cuyo coste crece en proporción a la longitud del texto, y no a su cuadrado. El modelo de 7.000 millones de parámetros mantiene además una huella de memoria constante, sea cual sea la longitud de la entrada. El de 76.000 millones solo la mantiene en parte, gracias a su arquitectura híbrida.
Neuronas de impulsos, cómo funcionan
La segunda idea, la que dio nombre al proyecto, viene de la neurociencia. En una red neuronal artificial convencional, cada neurona calcula de forma continua un valor numérico. En un cerebro biológico, una neurona permanece en silencio hasta que se supera un umbral y entonces emite un breve impulso, un «spike». La información reside en el momento y la frecuencia de esos impulsos, más que en una cifra.
SpikingBrain toma prestado este principio con neuronas de impulsos adaptativas, cuyo umbral de activación se ajusta. En la práctica, buena parte del cálculo simplemente no se realiza cuando la señal es nula. De ahí esa dispersión del 69,15 %: se evitan casi siete operaciones de cada diez. El eslogan según el cual la máquina «solo piensa cuando lo necesita» es una imagen atractiva, pero sigue siendo una imagen. El modelo no decide pensar: algunas de sus neuronas artificiales se quedan sencillamente en cero.
Otro punto que a menudo se pasa por alto es que los investigadores no construyeron sus modelos desde cero. Describen un proceso de entrenamiento por conversión, compatible con modelos existentes. Los 150.000 millones de tokens mencionados corresponden a una fase de preentrenamiento continuo, y los esquemas del informe indican que la fase inicial de preentrenamiento utilizó más de 10 billones de tokens. Decir que el modelo se entrenó con «una fracción de los datos» es exacto para esta etapa, pero no significa que ahora pueda fabricarse un modelo de este nivel con el 2 % de los recursos.
Las cifras que conviene leer con cautela
Estas son las cifras clave, con su alcance exacto:
- Aceleración superior a 100× del TTFT, para secuencias de 4 millones de tokens, con el modelo de 7.000 millones de parámetros, frente a referencias Transformer.
- Dispersión del 69,15 % en el esquema de impulsos propuesto.
- Unos 150.000 millones de tokens de preentrenamiento continuo, para un rendimiento calificado de comparable al de referencias de código abierto.
- Entrenamiento estable durante varias semanas en cientos de chips MetaX C550.
- Una versión comprimida de 1.000 millones de parámetros, desplegada en procesadores móviles, que según los autores logra una mejora de unas 15 veces en secuencias de 256.000 tokens.
Queda la cifra que dio la vuelta a la red, la del 97 % de ahorro energético. No aparece en el resumen del informe, que solo habla de un funcionamiento «de bajo consumo» posibilitado por la dispersión. Por lo que he leído, se trata de una estimación teórica basada en operaciones elementales, y no de una medición del consumo eléctrico de un sistema en condiciones reales. La distinción es esencial. Los procesadores gráficos actuales están diseñados para el cálculo denso y aprovechan mal la actividad dispersa, de modo que los ahorros teóricos no se traducen automáticamente en una factura eléctrica menor. Las ganancias completas exigirían, con el tiempo, chips neuromórficos o circuitos pensados para un funcionamiento orientado a eventos.
Del mismo modo, la aceleración de 100× no significa que SpikingBrain sea cien veces más rápido que los modelos actuales en el uso corriente. Describe un caso extremo, el de una entrada muy larga en la que la atención cuadrática está en su peor momento. Con textos cortos la diferencia se reduce notablemente, y los modelos de vanguardia han acumulado, por otra parte, numerosas optimizaciones para contener ese coste.
Una apuesta geopolítica además de técnica
Más allá de la arquitectura, parte del interés del proyecto reside en el hardware. Los autores destacan que el entrenamiento y el despliegue se realizaron en un clúster de chips MetaX, un fabricante chino, en lugar de componentes de Nvidia. Ven en ello la prueba de que se pueden desarrollar grandes modelos en una plataforma que no es de Nvidia, con un entrenamiento estable durante varias semanas.
En el contexto de las restricciones estadounidenses a la exportación de semiconductores avanzados a China, el mensaje es claro. Se trata de demostrar que un ecosistema nacional, del software a los chips, puede funcionar. Guoqi Li presenta además el proyecto como una vía nueva, optimizada para las plataformas chinas.
Con todo, conviene evitar hablar de una elusión «completa» de la dependencia occidental. Entrenar un modelo de 7.000 o de 76.000 millones de parámetros está lejos de la escala que alcanzan los laboratorios estadounidenses más avanzados. Y, sobre todo, la cuestión industrial sigue abierta: producir estos chips en volumen, con un rendimiento y un coste competitivos, es un desafío distinto de la demostración científica.
Las reservas que cabe formular
Quedan varias preguntas abiertas, y las planteo en nombre propio, ya que hasta ahora no se ha documentado ninguna reacción independiente.
La primera se refiere a la calidad. Un rendimiento «comparable» al de referencias de código abierto no significa equivalente al de los mejores modelos del momento. Tampoco dice nada sobre la solidez del modelo en tareas de razonamiento complejo o en contextos realmente de varios millones de tokens.
La segunda afecta a la propia comparación. Una ganancia de 100× depende del modelo de referencia elegido, de su implementación y del hardware utilizado. Solo una evaluación realizada por terceros, sobre bases comunes, permitirá consolidarla. El código del modelo de 7.000 millones de parámetros se ha hecho público, lo que hace posible esa verificación.
La tercera es la del hardware. Si la ventaja energética se confirma en circuitos adecuados, esos circuitos tendrán que existir a escala industrial. Por ahora, la IA orientada a eventos funciona en un hardware que no fue concebido para ella.
A la inversa, los escépticos se equivocarían al descartar el tema. La idea de reducir la dependencia del cálculo denso, abaratar el coste de los contextos largos y hacer que la IA pueda ejecutarse en dispositivos modestos responde a una necesidad real, en un momento en que el consumo eléctrico de los centros de datos se convierte en un asunto político.
Y ahora, qué
De SpikingBrain retengo menos una ruptura que una señal. Un equipo de investigación ha demostrado que es posible convertir modelos existentes a una arquitectura más económica, entrenarla de forma estable en hardware que no es de Nvidia y obtener ganancias muy marcadas en una categoría concreta de tareas. Eso basta para merecer atención, pero no para hablar de «cerebro humano» ni de una revolución consumada.
Lo que venga se jugará en tres frentes: las evaluaciones independientes, la posible llegada de hardware adaptado a las redes de impulsos y la capacidad de escalar a modelos de mayor tamaño. Puede que la naturaleza resolviera el problema de la eficiencia hace millones de años, pero la ingeniería aún sigue tratando de alcanzarla.
Preguntas frecuentes
¿SpikingBrain funciona realmente como un cerebro humano?
No. Se inspira en ciertos principios biológicos, como la activación por umbral y por impulsos, pero sigue siendo un modelo de lenguaje matemático que se ejecuta en chips convencionales.
¿La aceleración de 100× vale para todos los usos?
No. Se refiere al tiempo hasta el primer token, para una entrada de 4 millones de tokens, con el modelo de 7.000 millones de parámetros. Con textos cortos la diferencia es mucho menor.
¿SpikingBrain prescinde de Nvidia?
Se entrenó y se probó en chips MetaX, un fabricante chino. Esto demuestra la viabilidad técnica, pero no que ya sea posible una producción a gran escala sin componentes occidentales.
¿Se pueden verificar estos resultados?
En parte. El informe técnico es público y el código del modelo de 7.000 millones de parámetros está disponible, lo que permite a equipos independientes comprobar los resultados anunciados.