它确实存在,有公开的技术报告,其成果值得关注。但研究人员的说法与网络上的以讹传讹之间,差距相当大。我想把二者区分开来。
研究究竟说了什么?
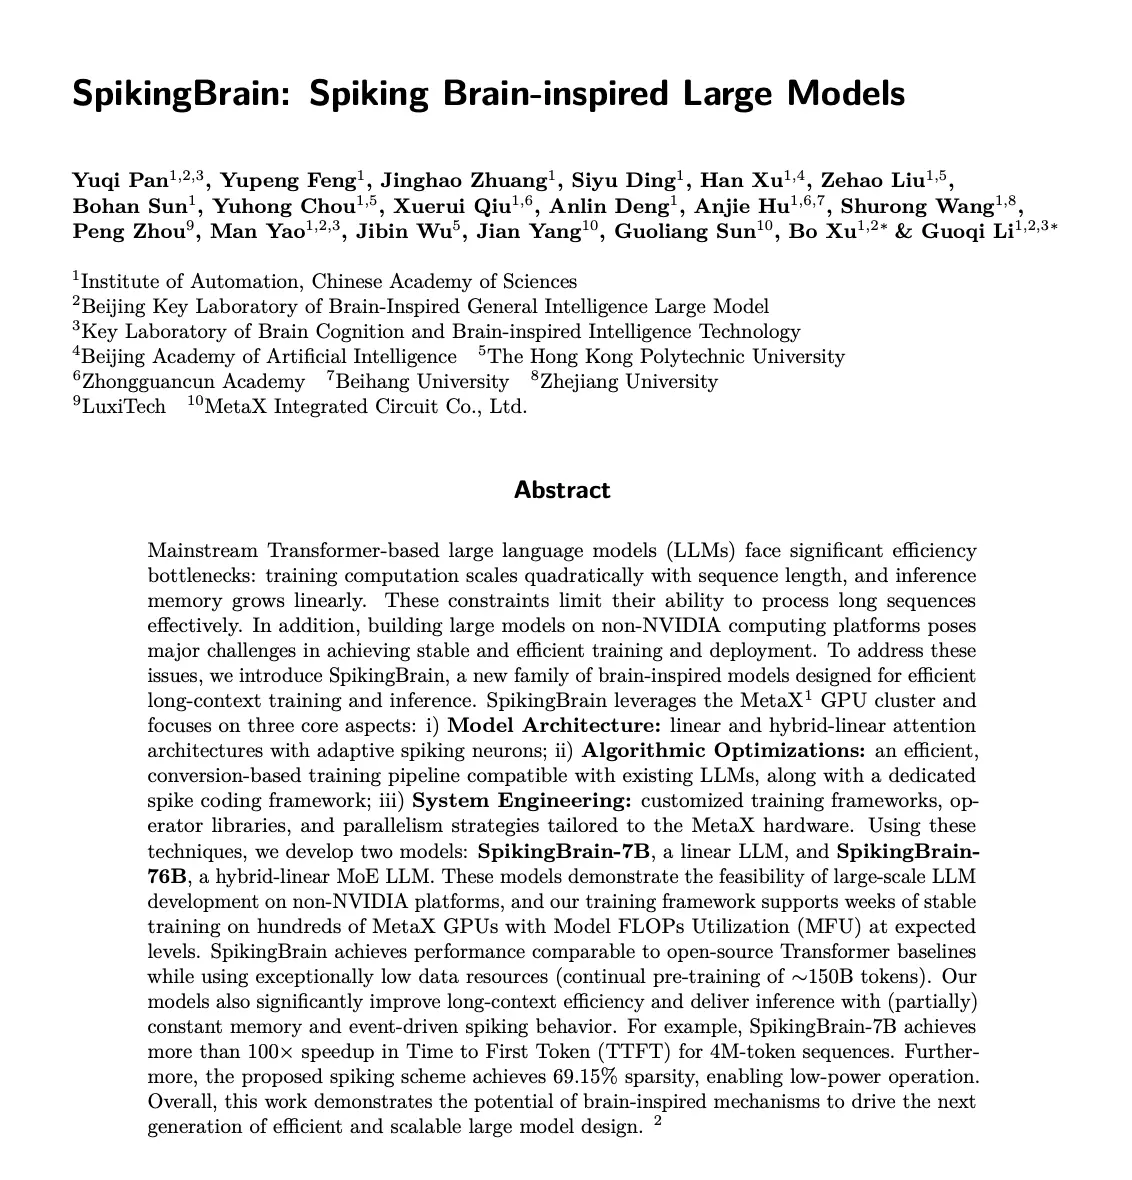
SpikingBrain 是一个语言模型系列,由位于北京的中国科学院自动化研究所开发。参与该项目的机构包括半导体企业 MetaX、LuxiTech 公司、香港理工大学和北京智源人工智能研究院。报告的署名者中有 Bo Xu 和 Guoqi Li,后者被介绍为这一方法的提出者。
该系列包含两个模型。第一个是 SpikingBrain-7B,一个拥有70亿参数的”线性”模型。第二个是 SpikingBrain-76B,一个混合”专家混合”(MoE)模型,处理每个词时只调用一部分参数,根据模型命名推断约为120亿。
作者提出了三项主要成果。第一,在70亿参数模型上测得,处理400万词元(token)序列时,首词元延迟(TTFT)加速超过100倍。第二,仅用1500亿词元的持续预训练,性能即可与开源的 Transformer 基准模型相当。第三,实现稀疏激活:69.15%的”脉冲”类运算保持静默。
这些数字都来自研究人员自己。据我所知,目前尚未发表任何大规模的独立复现,这一点之后还需要再核实。
为什么 Transformer 在长上下文上遇到瓶颈?
要理解其意义,必须回到主流模型,即 Transformer 架构的工作方式。其核心机制”注意力”会把文本中的每个词与其他所有词进行比较。因此,计算成本随序列长度呈平方增长:文本长度翻一倍,计算量就变成四倍。在推理阶段,保存上下文所需的内存则随词元数量线性增长。
这就是”长上下文”的瓶颈所在,无论是分析一整份法律卷宗、一个代码库,还是数小时的转录文本。项目报告人在开篇就指出了这一点:这些限制制约了模型高效处理超长序列的能力。
SpikingBrain 正是针对这一点。所谓”线性”架构,用一种成本与文本长度成正比(而非平方)的机制取代了传统注意力。此外,70亿参数模型无论输入多长,内存占用都保持恒定。76B 模型由于采用混合架构,只能部分做到这一点。
脉冲神经元如何工作?
第二个理念为项目赢得了名字,它来自神经科学。在传统人工神经网络中,每个神经元持续计算一个连续的数值。而在生物大脑中,神经元在未达到阈值前保持沉默,一旦越过阈值,便发出一个短暂的脉冲,即”spike”。信息因此更多地蕴含在这些脉冲的时刻和频率中,而不是某个具体数值。
SpikingBrain 借用了这一原理,采用所谓”自适应发放”神经元,其激活阈值可以调整。具体来说,当信号为零时,很大一部分计算根本不会发生。这就是69.15%稀疏度的由来:十次运算中约有七次被省去。”机器只在需要时才思考”这句口号是个很有吸引力的比喻,但也仅仅是比喻。模型并不会决定是否思考,只是它的一些人工神经元恰好停留在零。
另一点常被忽略:研究人员并非从零开始构建模型。他们描述了一条基于转换的训练流程,可与现有模型兼容。提到的1500亿词元对应的是持续预训练阶段。报告中的图示提醒我们,最初的预训练阶段涉及超过10万亿词元。因此,说模型”只用了一小部分数据”,就这一阶段而言是准确的,但这并不意味着现在只需2%的资源就能造出同等水平的模型。
需要谨慎解读的数字
以下是关键数字及其确切适用范围:
- 首词元延迟(TTFT)加速超过100倍,针对400万词元的序列,使用70亿参数模型,对比 Transformer 基准。
- 所提出的脉冲方案稀疏度为69.15%。
- 约1500亿词元的持续预训练,性能与开源基准相当。
- 在数百块 MetaX C550 芯片上稳定训练数周。
- 一个10亿参数的压缩版本,部署在移动端处理器上,据作者称,在25.6万词元序列上约有15倍的加速。
最后是那个在网上流传的数字:节能97%。它并未出现在报告摘要中,摘要只提到稀疏性带来的”低功耗”运行。据我所读到的资料,它是针对基本运算的理论估算,而不是对真实条件下系统用电量的实测。这一区别至关重要。当前的图形处理器是为密集计算设计的,很难从稀疏活动中获益,因此理论上的节能并不会自动体现在电费账单上。要获得完整收益,最终需要类脑芯片或专为事件驱动运行设计的电路。
同样,100倍的加速也并不意味着 SpikingBrain 在日常使用中比现有模型快一百倍。它描述的是一种极端情形,即输入极长,二次方注意力恰好处于最糟的状态。对于短文本,差距会明显缩小,而且前沿模型也已经做了大量优化来控制这一成本。
技术之外,也是地缘政治
除了架构本身,该项目的部分意义在于硬件。作者强调,训练和部署是在中国厂商 MetaX 的芯片集群上完成的,而不是 Nvidia 的组件。他们认为这证明了可以在非 Nvidia 平台上开发大模型,并实现数周的稳定训练。
在美国限制向中国出口先进半导体的背景下,这一信息不难解读:它要表明,从软件到芯片的国产生态可以运转。顺带一提,Guoqi Li 将该项目描述为一条针对中国平台优化的新路径。
不过,仍应避免谈论对西方依赖的”完全”摆脱。训练70亿或760亿参数的模型,与美国最先进实验室所达到的规模相去甚远。更重要的是,产业层面的问题依然存在:要以有竞争力的性能和成本批量生产这些芯片,是与科学验证截然不同的挑战。
可以提出的保留意见
仍有若干问题悬而未决。由于目前没有记录在案的独立反应,以下是我以个人名义提出的。
第一是质量。与开源基准”相当”的性能,并不等于与当前最佳模型相当,也无法说明模型在复杂推理任务或真正达到数百万词元的上下文中是否稳健。
第二涉及比较本身。100倍的提升取决于所选的参照模型、其实现方式以及所用硬件。只有第三方在共同基准上进行评估,才能巩固这一结论。70亿参数模型的代码已经公开,这使得验证成为可能。
第三是硬件。即便能源优势在合适的电路上得到证实,这些电路还得能以产业规模存在。目前,事件驱动的AI运行在并非为它设计的硬件上。
反过来说,怀疑者若对此不屑一顾,也是错误的。减少对密集计算的依赖、降低长上下文的成本、让AI能在普通设备上运行,这些想法回应了真实的需求,尤其是在数据中心的耗电正成为政治议题的今天。
接下来呢?
在我看来,SpikingBrain 与其说是一次突破,不如说是一个信号。一支研究团队证明了:可以把现有模型转换为更节能的架构,在非 Nvidia 硬件上稳定训练,并在特定类别的任务上取得非常显著的收益。这足以值得关注,但还不足以谈论”人脑”或一场已然完成的革命。
后续将在三个方面见分晓:独立评估、适用于脉冲网络的硬件能否出现,以及能否扩展到更大规模的模型。大自然也许在数百万年前就解决了效率问题,但工程学仍在奋力追赶。
常见问题
SpikingBrain 真的像人脑一样工作吗?
不是。它借鉴了一些生物学原理,比如阈值激活和脉冲,但本质上仍是一个运行在常规芯片上的数学语言模型。
100倍的加速适用于所有使用场景吗?
不适用。它指的是首词元延迟,针对400万词元的输入,使用70亿参数模型。在短文本上,差距要小得多。
SpikingBrain 能摆脱 Nvidia 吗?
它是在中国厂商 MetaX 的芯片上训练和测试的。这证明了技术上的可行性,但并不证明不依赖西方组件的大规模生产已经可以实现。
这些结果可以验证吗?
部分可以。技术报告已公开,70亿参数模型的代码也可获取,独立团队可以据此测试所宣称的结果。